Когда компания запускает агентов, вычислительная нагрузка перестаёт быть однородной. GPU считает инференс, CPU ведёт сотни параллельных сессий и вызывает инструменты, оперативная память хранит контекст, а хранилище — векторы, журналы и артефакты.
Анонсированная 12 октября 2026 года архитектура AMD Helion интересна не как готовый список покупок, а как признание этой разницы. В ней есть CPU-ориентированная схема для исполнения агентов и вариант CPU/GPU для компаний, которым нужен инференс в том же контуре.
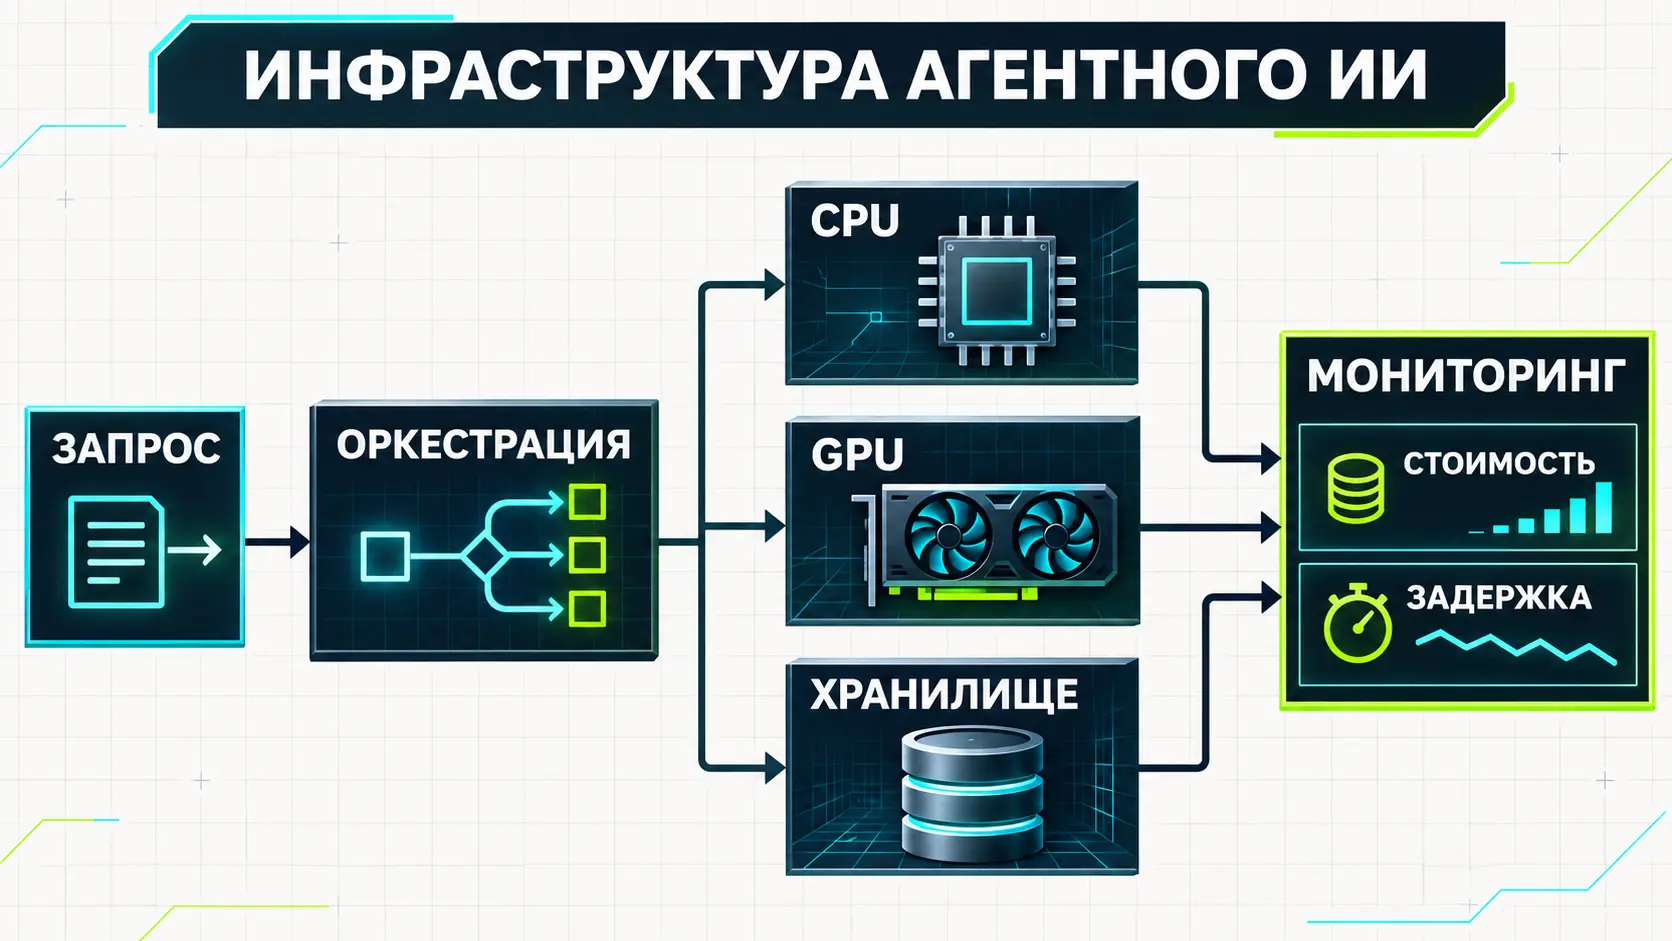
Сначала нагрузка, потом конфигурация
Покупать железо «для ИИ» без профиля нагрузки — всё равно что проектировать склад по среднему размеру коробки. Нужно знать не только модель и число токенов, но и число одновременных агентов, длину сессий, частоту вызовов инструментов, размер индекса и пики.
Для каждого сценария полезно собрать профиль за 10–14 дней: медиана и 95-й перцентиль задержки, токены на шаг, число шагов на задачу, CPU-время оркестрации, GPU-время, объём памяти на сессию, чтение и запись в хранилище. Без этих данных любая спецификация будет догадкой.
Как разделить CPU и GPU
GPU нужен там, где много матричных операций: локальный инференс, эмбеддинги, ранжирование. CPU занимается тем, что плохо масштабируется на GPU: проверка политик, JSON-преобразования, сетевые вызовы, планирование, изоляция и журналы. Если запросы к модели идут в облако, локальный GPU может вообще не понадобиться.
| Узел | Критичная характеристика | Что можно масштабировать отдельно |
|---|---|---|
| Оркестрация | Ядра, RAM, сетевые сокеты | CPU-узлы |
| Инференс | VRAM, пропускная способность, батчинг | GPU-реплики |
| Контекст и кэш | RAM и задержка | In-memory узлы |
| Векторный индекс | IOPS, RAM, задержка сети | Шарды и реплики |
| Журналы | Пропускная способность и срок хранения | Коллекторы и хранилище |
Маршрутизатор моделей снижает расходы
Не каждому шагу нужна самая большая модель. Классификацию, извлечение полей и проверку формата можно отдать малой или локальной модели, а сложное рассуждение — большой. Маршрутизатор должен учитывать не только цену токеа, но и требуемую задержку, класс данных и допустимое качество.
Собирая лабораторный стенд, лучше начать с одной-двух нагрузок и обычного модульного железа. Так проще сравнить серверные платформы по числу слотов, объёму RAM, хранилищу и сетевым интерфейсам, а затем понять, какой узел действительно стал узким местом.
Сеть и хранилище легко недооценить
Агент может сделать десятки мелких вызовов за один пользовательский запрос. Поэтому канал, который выглядит свободным на среднем графике, может давать очередь на пике. Измеряйте не только мегабиты, но и задержку, число соединений и повторы.
Для хранилища разделяйте горячий кэш, векторный индекс, журналы и архив. У них разные требования к IOPS, стоимости и сроку хранения. Один дорогой массив для всего обычно хуже двух уровней с понятной политикой перемещения.
Как считать стоимость
Цена сервера мало говорит о цене агента. Нужна стоимость завершённой бизнес-задачи: инференс, CPU, память, хранение, сеть, лицензии, инженерное время и доля неудачных прогонов. Если агент делает пять попыток, дешёвый токен не спасает экономику.
На пилоте считайте три цифры: рубли на задачу, минуты до готового результата и долю задач, которые пришлось переделать человеку. Только их совместная динамика показывает, нужно ли масштабировать стенд.
Официальный материал
Нужен взгляд на вашу инфраструктуру?
Опишите текущую задачу — предложим, с какой диагностики или документа начать.
Обсудить задачу →