Kubernetes 1.37 вышел 26 августа 2026 года, а осенью одной из самых обсуждаемых тем стала память. Это не случайно: AI-нагрузки, векторные базы и пакетные задачи быстро занимают RAM и чувствительны к давлению памяти на узле.
В 1.37 функция Memory QoS перешла в бета-статус и включена по умолчанию на Linux-узлах с cgroup v2. Она не добавляет память и не отменяет необходимость задавать requests и limits. Её задача — дать ядру Linux более точные сигналы о том, какую память защищать, а какую отбирать первой.
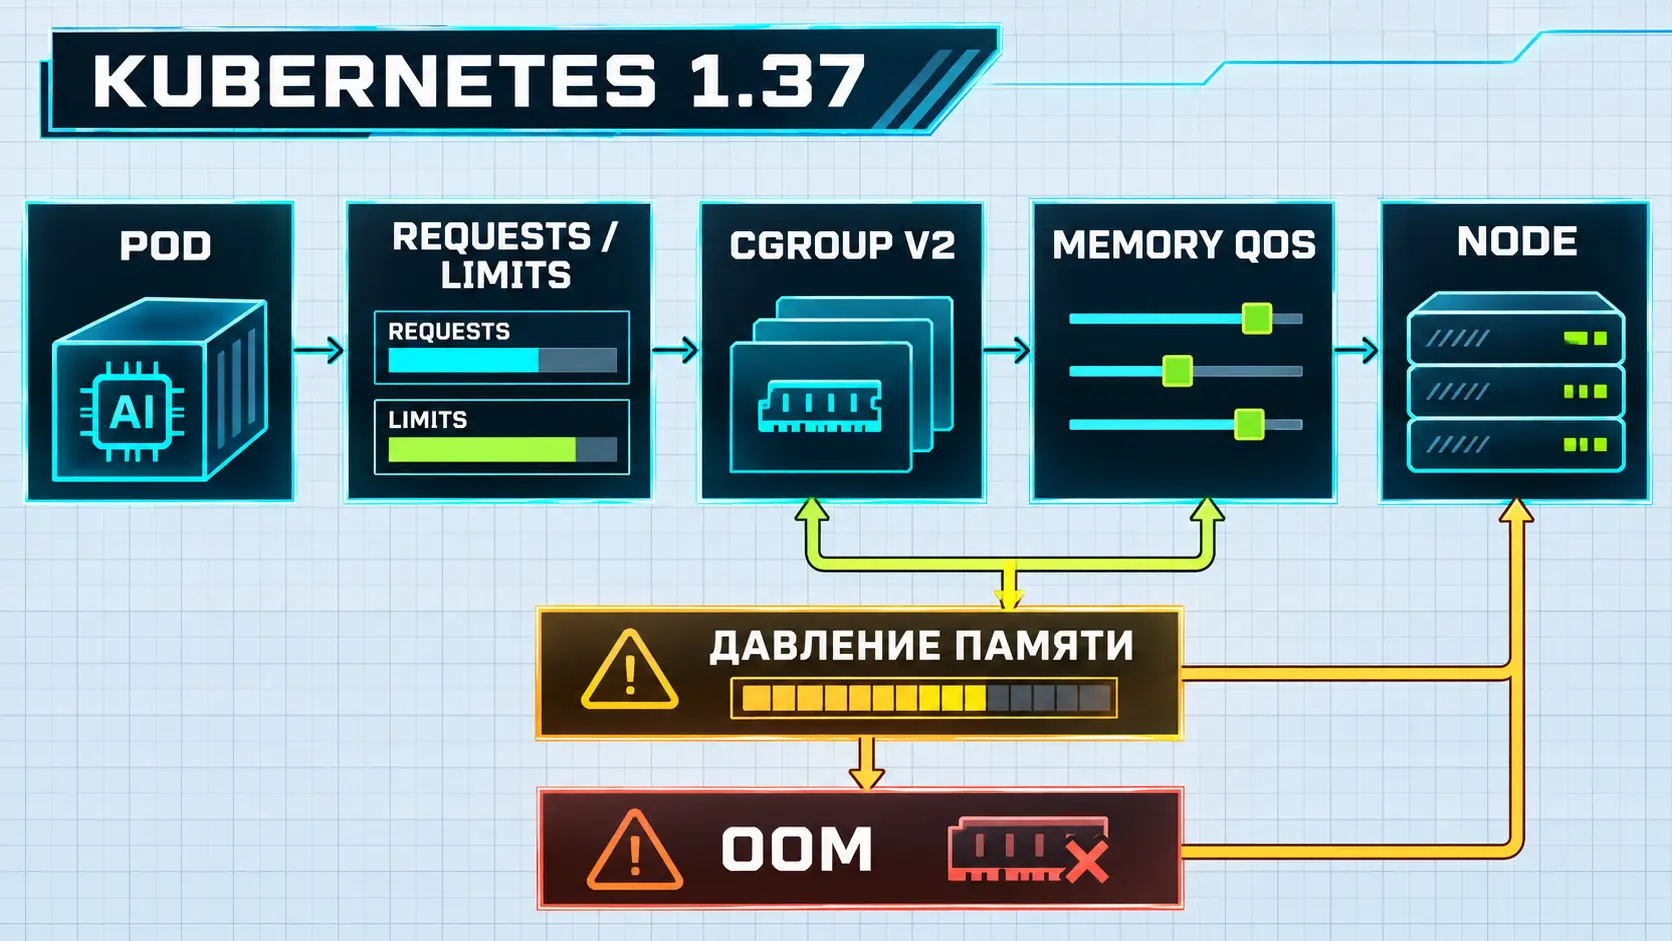
Что меняет Memory QoS
Без Memory QoS два Pod с одинаковым классом QoS могут слишком поздно увидеть, что узел заканчивается. Механизм связывает Kubernetes requests и limits с контроллером памяти cgroup v2. В результате ядро может раньше ограничивать избыточный рост и лучше сохранять память для гарантированных нагрузок.
Но если request занижен в четыре раза, механизм защищает не реальную нагрузку, а ошибку в манифесте. Поэтому после апгрейда нужно смотреть не только на OOMKilled, но и на throttling, memory pressure, задержку и частоту перезапусков.
Requests и limits для AI-нагрузок
У AI-задач часто есть три фазы: загрузка модели или индекса, рабочее плато и пик. Среднее значение за час плохо описывает все три. Для request лучше брать устойчивое рабочее плато с запасом, а limit ставить выше измеренного пика, если приложение умеет корректно обрабатывать отказ.
| Симптом | Вероятная причина | Что проверить |
|---|---|---|
| OOMKilled на пике | Limit ниже реального пика или утечка | working set, heap, число параллельных запросов |
| Вытеснение соседей | Request занижен | Долю памяти сверх request и QoS-класс |
| Долгий старт | Модель или индекс не помещаются в кэш | page faults, IO, размер кэша |
| Нестабильная задержка | Давление памяти или GC | PSI, throttling, pauses GC |
Отдельные пулы узлов лучше одного универсального
Не смешивайте на одних узлах латентно-критичный инференс, пакетную индексацию и обычные веб-сервисы. У них разный профиль памяти и разная цена простоя. Разделение через taints, tolerations и node affinity позволяет задать для каждой группы свои таймауты, приоритеты и политики автоскейлинга.
Для пакетных задач можно допустить более высокую утилизацию и медленное завершение. Для онлайн-инференса важнее запас и предсказуемая задержка. Один процент средней загрузки не означает одинаковое качество.
План апгрейда с 1.34–1.36
Ветка 1.34 достигла конца поддержки 27 октябя 2026 года. Если кластер остался на ней, не нужно совмещать апгрейд с массовой перенастройкой ресурсов. Сначала перенесите контрольную плоскость и узлы, затем зафиксируйте базовые метрики, и только потом меняйте requests и limits.
- Проверьте version skew, API deprecations и совместимость CNI, CSI, ingress и операторов.
- Обновите непродуктивный кластер и прогоните типовые пики.
- Включите канареечный пул узлов и сравните PSI, OOM, рестарты и p95-задержку.
- Перенесите один класс нагрузок, а не все namespace сразу.
- После стабилизации пересчитайте requests по новым данным.
Какие метрики собирать
Минимальный набор: working set контейнеров, requests и limits, доля памяти сверх request, OOMKilled, рестарты, PSI на узле, page faults, задержка приложения и длина очереди. На графиках нужно видеть не только среднее, но и пики по минутам.
Признак успеха не в том, что все контейнеры перестали падать. Нужно, чтобы при том же SLA снизились взаимное вытеснение, аварийные перезапуски и разброс задержки. Иначе кластер может стать более «стабильным» только за счёт избыточного ограничения производительности.
Официальные материалы
- Kubernetes Blog: материалы по Kubernetes 1.37, Memory QoS и cgroup v2
- Kubernetes: поддерживаемые ветки и сроки EOL
Нужен взгляд на вашу инфраструктуру?
Опишите текущую задачу — предложим, с какой диагностики или документа начать.
Обсудить задачу →