Коротко: Мониторинг полезен, когда каждый сигнал имеет владельца, порог и действие; зелёный ping ещё не означает работу сервиса.
Сервер может отвечать на ping, но приложение уже недоступно, диск заполнен или срок сертификата истекает. Поэтому наблюдение строят слоями: инфраструктура, служба, бизнес-транзакция и внешняя зависимость.
Контролируйте симптомы и причины
Загрузка процессора помогает диагностике, но бизнесу важнее доступность приложения и время ответа. Метрики обоих уровней связывают на одной временной шкале.
Настройте полезные пороги
Слишком чувствительные правила создают усталость от уведомлений. Порог учитывает длительность, тренд и рабочее окно, а критичный сигнал отправляется дежурному каналу.
Проверяйте сам мониторинг
Система наблюдения тоже может перестать собирать данные. Нужен контроль пропавших метрик, доставки уведомлений и резерв настроек.
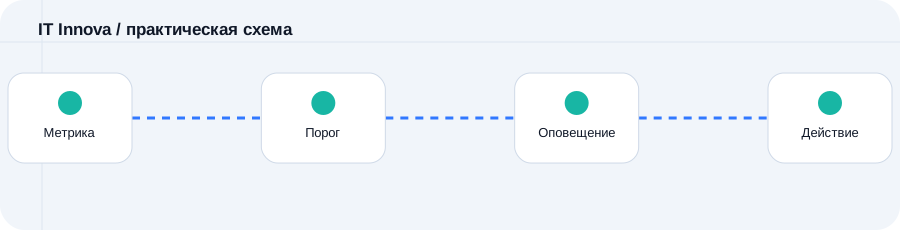
Практический чек-лист
- Составить список критичных сервисов
- Назначить владельца каждому сигналу
- Отделить предупреждение от аварии
- Добавить контроль бэкапов
- Проверять доставку оповещений
Что зафиксировать в документах
| Объект | Что записать | Зачем |
|---|---|---|
| Инфраструктура | CPU, память, диск, сеть | Диагностика причины |
| Сервис | Порт, процесс, время ответа | Контроль доступности |
| Сценарий | Вход, запрос, операция | Проверка глазами пользователя |
Частые вопросы
Нужен ли мониторинг 24/7?
Критичные системы следует контролировать постоянно, но график реакции согласуется отдельно.
Сколько метрик собирать?
Столько, сколько помогает принять решение; объём без действий не повышает надёжность.
Вывод
Хороший мониторинг сокращает время обнаружения и диагностики, не превращая инженеров в операторов бесконечной ленты сигналов.
Нужен взгляд на вашу инфраструктуру?
Опишите текущую задачу — предложим, с какой диагностики или документа начать.
Обсудить задачу →